本文结构
1. 执行摘要
客户体验是 agentic AI 中变化最快的领域 —— 也是『演示能跑』与『此刻仍在这位客户的这段对话中正常工作』之间 差距最大的领域。当 CX 智能体面对真实的、无边的、有时是敌意的用户,问题就从模型准确性问题 变成了系统问题。
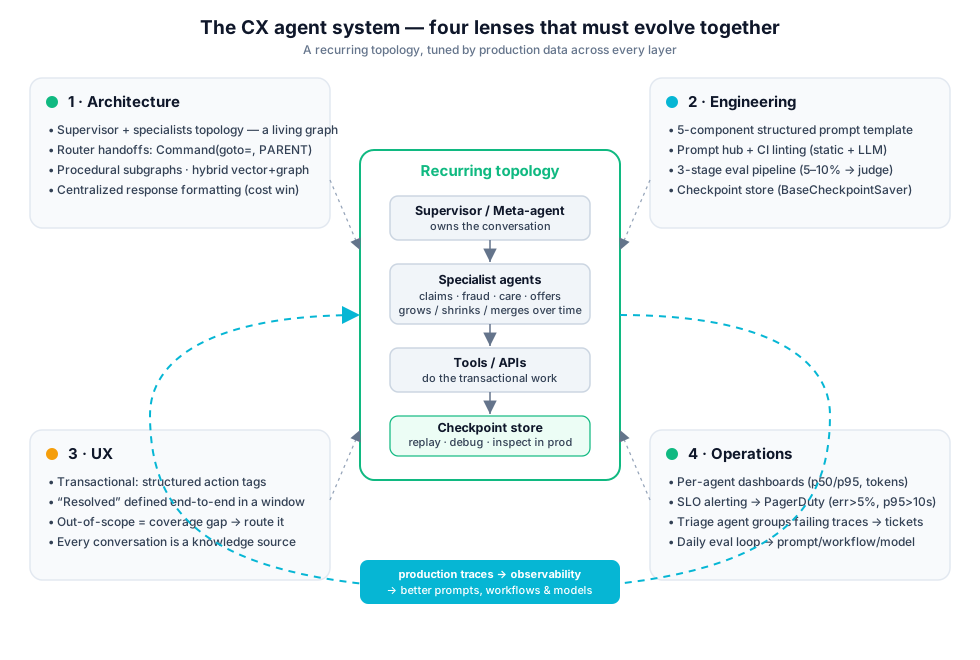
组织框架是四重视角模型 —— 架构、工程、体验、运维 —— 四者必须协同演进, 由同一份生产数据驱动。本文的四个案例研究为每个论断提供证据。
2. 为什么 CX 智能体是另一类问题
无边界的对抗性用户
客户可以问任何问题 —— 包括智能体没有工具、没有政策答案、没有业务依据来处理的问题。『超出范围』的边界不是事先的产品决策,而是一个数据发现问题:你从读取 trace 中发现它,而不是从规范里定义它。
价值在于『做』
只回答问题的 CX 智能体只是一台问答机器。价值在于执行 —— 激活优惠、停用服务、更新支付方式、提交理赔 —— 通过前端或后端能在对话内执行的结构性动作标签(structured action tags)。
『已解决』是端到端的
当智能体说『已为你升级处理』时,理赔并没有解决。它要收集证据、调用工具、应用决策规则、解释结果 —— 并在定义的时间窗口内完成,才算解决。
主线:一个 CX 智能体不是单个『智能体』。 它是一个由架构、工程、体验、运维四个相互作用层组成的系统,必须协同演进。
3. 四重视角模型
本文最重要的一个想法:把 CX 智能体当作四重视角构成的系统,而不是指向一个 FAQ 的模型。 每个视角是一门独立学科,有自己的产物,且四者由同一份生产数据驱动。
| 视角 | 回答的问题 | 关键产物 |
|---|---|---|
| 架构 | 拓扑是什么,如何演进? | Supervisor + 专家图、路由交接、子图、检索层 |
| 工程 | 智能体如何随规模增长保持正确? | 结构化 prompt 模板、prompt 中枢、CI 校验、评测流水线、checkpoint 存储 |
| 体验(UX) | 对『已解决』,客户意味着什么? | 交易型动作标签、端到端解决、超范围路由、知识捕获 |
| 运维 | 如何知道它此刻仍在正常工作? | 每智能体仪表盘、SLO、告警/呼叫、分诊智能体、每日评测循环 |
四个视角不是顺序阶段 —— 它们是耦合的。架构上的变化(新增一个专家) 会倒逼新的工程(prompt、工具、评测),改变 体验(客户现在能问什么),并带来新的 运维(新 SLO、新仪表盘)。 生产 trace 是同时推动四者的共享信号。
4. 什么让 CX 智能体与众不同
4.1 · 用户无边界且具对抗性
输入无法受限。LATAM 的 Concierge 最初将 13% 的消息判为超范围 —— 其中 95% 是乘客的合理需求。增加一个客服专家后,超范围率降到 1%,复访率提升 6%。
4.2 · 对话是交易型
价值在于『做』。智能体返回前端或后端可在对话内执行的动作标签 —— 激活优惠、更新支付方式。沃达丰 Super TOBI 由此从聊天机器人变成交易型工作流。
4.3 · 『已解决』有明确的端到端含义
司机损坏理赔在智能体说『已升级』时并没有解决 —— 照片收集、工具取数、欺诈信号、决策与解释都完成才算解决。Lyft 65% 的拦截率与 35% 的 AI 解决率,正是按这一定义构建的直接结果。
4.4 · 对话是知识来源
每次交互都包含意图、偏好、未满足需求与未来信号。LATAM 的 Compass 把非结构化对话语料变成结构化知识:实体与关系映射到领域本体(ontology),写入知识图谱。本体 —— 而不是模型 —— 才是专有资产。
4.5 · 实时延迟与成本在运维上很重要
支持队列里的 CX 智能体有 p95 延迟预算;处于费用争议的司机不会等 30 秒。每个生产中的智能体都应有专属仪表盘:运行量、错误率、p50/p95 延迟、token 用量、工具调用成功率、judge 评分 —— 并配一条在真实 SLO 上触发的运维告警。
4.6 · 用户也可以是操作者
同样的纪律也适用于用户在配置自己环境(而非向企业求助)的场景。Cloudflare 的智能体让用户在一张纯『白页』上以对话方式配置自己的 Workers、DNS 与网络 —— 没有仪表盘,只有聊天。超范围边界、安全门禁与评测纪律不变;变的是信任模型:智能体作用于用户自己的资源,以用户自己的权限。
5. 真正的难点
难的部分不是『让 LLM 答对』。它们是运营与组织层面的问题。
评测是新的测试套件 —— 且比单元测试更难
- ▸ 通用分数(『有用性 4/5』)没有可执行性。对照人工标注校准的二元通过/不通过判定是最低标准。
- ▸ 离线模拟必要但不充分:过于礼貌的模拟用户会让在离线通过、在生产失败的智能体蒙混过关。人格(personas)要基于真实客户原话。
- ▸ 评测流水线本身是产品:5–10% 生产小流量 → 采样 trace → LLM-as-a-Judge 自动评测。
- ▸ 每日节奏很重要:发布前跑一次是发布门禁;在滚动的生产 trace 窗口上每日运行才是运维习惯。
Prompt 质量才是真正的瓶颈,而不是平台
- ▸ 当 Lyft 向非工程师开放智能体构建时,最难的部分不是工具绑定或状态管理 —— 是 prompt 质量:快乐路径写得好、边缘场景一塌糊涂的 prompt,含糊的语气章节,以及缺失的超范围定义。
- ▸ 解法:结构化五要素 prompt 模板 + CI 校验流水线(静态 + LLM 规则),任何违规都阻断合并。
- ▸ 把 prompt 当产品规格书,而不是代码注释。Prompt 越明确,智能体越一致。
五要素 prompt 模板
- 1 · 身份这个智能体是谁、面向什么用户、什么主题域。
- 2 · 首要目标具体动词 —— 不是含糊的『帮助』『处理』。
- 3 · 范围范围内与范围外都要写,超范围必须带明确的路由动作。
- 4 · 分阶段工作流编号步骤带进入条件,每个 if/else 都有分支,每个阶段都有终止动作。
- 5 · 内容规范带示例话术的具体 do/don't 规则,而不是抽象原则。
可观测性是第一天需求,不是事后复盘
- ▸ trace 每一次调用(dev / staging / 生产):哪些节点运行、LLM 看到什么、调用了哪些工具、token 用量、每步延迟。
- ▸ trace 附加自定义元数据(用户类型、智能体名、意图、会话 ID),每个生产智能体一张克隆仪表盘。
- ▸ 告警接入呼叫系统:15 分钟窗口内错误率超 5% 或 p95 延迟超 10 秒,自动呼叫 on-call。
- ▸ 构建分诊智能体:拉取失败 trace、归并相关问题、自动开单。人负责设计修复;分诊智能体负责分拣噪音。
架构在发布时并未完成
- ▸ Supervisor 模式、子图结构,甚至哪个智能体负责最终格式化 —— 都要在观察真实对话后调优。
- ▸ 发布一个能交接、收回控制权、重新路由的 supervisor。专家集将随生产 trace 所示增长、收缩、合并。
6. 智能体模式:反复出现的形状
三个支持类部署中同一个核心结构反复出现:Supervisor 或元智能体拥有对话, 专家智能体处理离散用例,工具 / API完成交易性工作。 真正重要的是这个结构内部的具体模式。
| 模式 | 做什么 | 出现于 |
|---|---|---|
| 带状态交接的路由器 | 每类用户一个独立路由实例;子智能体在领域切换时把控制权交还父级 —— Command(goto=…, graph=PARENT) | Lyft(乘客 vs 司机) |
| 专用 vs 可配置的拆分 | 复杂、高风险流程由 MLE 手工构建;自助层用 JSON 配置 + prompt 中枢 | Lyft |
| 过程性子图(『LLM 编译器』) | 过程存图数据库;LLM 选哪个过程、什么顺序;过程本身保持确定性 | 沃达丰(Neo4j) |
| 混合检索(向量 + 图) | 向量搜索找片段;图层承载片段间关系(『这条替代那条』) | 知识密集型 CX |
| 集中式格式化 | 把响应格式化从各专家收回 supervisor,换一致性与成本 | LATAM(成本降 15%) |
专用 vs 可配置的拆分是自助化的架构使能:新智能体由一个 prompt 加一份 JSON 配置定义,而不是工程出一个新状态图。平台负责图构建、工具执行、checkpoint、trace 与安全。
7. 支撑全局的架构
7.1 状态持久化与 checkpoint
多轮对话中,checkpoint 存储不是细节 —— 它是你能回答『第 7 步智能体到底看到并决定了什么』的能力。
每个节点执行后持久化完整图状态、执行元数据与父级 checkpoint 引用,从而支持会话回放、调试与生产状态检查。
接口是 LangGraph 的 BaseCheckpointSaver;实现与存储引擎无关 ——
serverless 用 DynamoDB,本地部署用 PostgreSQL(Lyft 用 DynamoDBSaver)。
7.2 本体层
若智能体回答政策、产品、流程类问题,检索层不应只是纯向量搜索。构建本体驱动流水线:解析非结构化来源(对话、访谈、法务文档) → 实体与关系映射到领域本体 → 写入知识图谱 → 查询时在图上做混合检索。 本体编码的是业务自己的定义 —— 这是持久资产;模型只是工具。
7.3 prompt 中枢是部署问题
prompt 中枢不只是 prompt 版本管理 —— 它是领域专家知识与运行中智能体行为之间的部署环节。 它应支持:带必填字段的结构化模板、激活前静态 + LLM 校验、带人工评审的 prompt A/B 评测、生产 trace 上的持续评分与自动劣化告警。 prompt 中枢让 prompt 质量从个人手艺变成工程纪律。
7.4 评测流水线是产品门禁
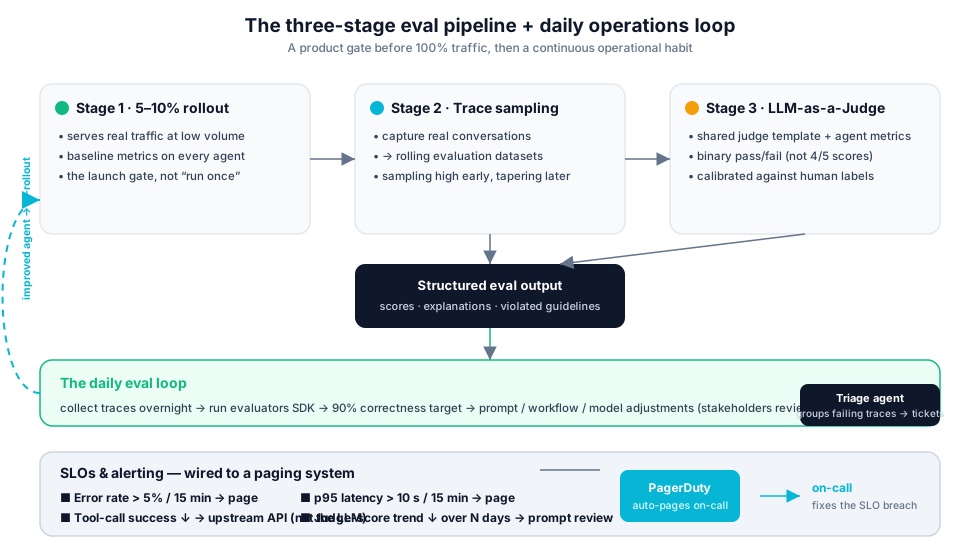
任何智能体全量放开之前,必须通过三级流程:
- 1.5–10% 小流量生产灰度 —— 智能体以低流量服务真实用户。
- 2.采样生产 trace —— 真实对话被捕获为评测数据集。
- 3.运行 LLM-as-a-Judge 评测器 —— 使用 prompt 中枢的共享 judge 模板并叠加智能体专属指标;采样率随信心提升而递减。
8. 日常运作:评测与运维
8.1 · 每日评测循环
夜间收集 trace,运行评测器,生成结构化输出 —— 分数、解释、违规条款。业务干系人每日评审并反馈 prompt 调整。 目标是90% 正确率,不是『看起来没问题』。
8.2 · 仿真基础设施
新智能体上线前,用 mock 工具响应跑合成对话:基于真实客户原话的人格(退款诉求者、AI 怀疑者、多语言客户)、 生产暴露的边缘场景、带人工评审的 prompt 修订 A/B 对比。在任何一个真实客户看到输出之前抓住回归。
8.3 · 分诊智能体
第二个智能体从可观测性平台拉取失败 trace、归并相关问题、自动开单。它不修复任何东西 —— 它分拣噪音, 让人类工程师把时间花在修复而不是分诊上。
8.4 · SLO 与告警
| 信号 | 阈值 | 动作 |
|---|---|---|
| 错误率 | 15 分钟持续 > 5% | 呼叫 on-call |
| p95 延迟 | 15 分钟持续 > 10 秒 | 呼叫 on-call |
| 工具调用成功率 | 跌破阈值 | 上游 API 问题,不是 LLM |
| judge 评分趋势 | 连续 N 天下降 | prompt 评审(不呼叫) |
目标不是一块漂亮的 Grafana 屏幕。它是一条把糟糕交互转化为更好的 prompt、工作流与模型的结构化流水线 —— 并且在越线时戳一下 on-call。
8.5 · 智能体级遥测
上述纪律并非 CX 专属。Cloudflare 2026 年的智能体追踪发布从基础设施一侧点名了同样的失效模式: 『智能体可以返回 HTTP 200 却仍然失败 —— 选错工具、给子智能体传入过期上下文、或在重试循环里烧 token。』 传统应用遥测显示的是 HTTP 请求或数据库查询 —— 而不是造成它的智能体行为。Cloudflare 的答案是嵌套在 Workers 基础设施 span 内的智能体感知式 span:模型调用、工具执行、子智能体交接、token 用量都是一等 trace 节点,可导出到任何 OpenTelemetry 兼容目的地。两种视图:回放会话(完整对话)与 检查追踪(执行瀑布流 —— 时间花在哪、 哪个子智能体干了多少活、哪些 D1/KV 调用被触发)。与 Lyft 相同的 SLO 纪律 —— 但遥测是智能体级而非 HTTP 级。
9. 案例研究:证据
沃达丰 / Fastweb
Super TOBISupervisor + 用例智能体,每个带明确 API 集,遵循『LLM 编译器』模式:Super Agent 路由到过程性子图(Neo4j 中存故障排查过程)或混合向量 + 图检索流水线。
交易操作的结构性动作标签 —— 激活优惠、停用服务、更新支付方式。智能体是工作流,不是问答机器。
Evaluators SDK 每日自动评测:夜间收集 trace、运行评测器、生成结构化输出(分数、解释、违规条款)。90% 正确率目标。
每日评测节奏;结构化输出面向非技术干系人设计 —— 不需要理解底层图就能读、能行动。
LATAM 航空
Concierge + Compass工具即智能体的布局,supervisor 向航班、预订、目的地、客服专家分派。响应格式化从各专家收回 supervisor:成本降 15% —— 只有读单条 trace 才抓到的发现。
最初 13% 的消息被判超范围;trace 显示 95% 是乘客的合理需求。增加客服专家后超范围率降到 1%;复访率升 6%。
Compass:本体驱动知识抽取 —— 解析非结构化来源、实体与关系映射到领域本体、写入知识图谱。本体才是专有资产。
trace 级可观测性揭示了重复格式化的成本问题与超范围发现;分诊智能体拉取失败 trace 并归并相关问题。
Lyft
自助智能体平台路由模式:乘客与司机各一个独立实例;Command(goto=…, graph=Command.PARENT) 用于对话中途交接。专用 vs 可配置拆分支持自助:新智能体 = 一个 prompt + 一份 JSON 配置,而不是新状态图。
五要素结构化 prompt 模板;基于 Git 的 prompt 校验 CI(静态 + LLM,阻断合并);三级评测流水线,judge 输出二元化;DynamoDBSaver 做状态持久化。
拦截率 65%,AI 解决率 35%。缺失超范围定义是最一致的 prompt 失效模式 —— 现在每个 prompt 必须带明确的超范围路由动作。
每智能体仪表盘;PagerDuty 集成:15 分钟窗口内错误率 > 5% 或 p95 > 10 秒自动呼叫 on-call。
新可配置智能体开发从约 6 个月缩短到约 2 周;100% 生产智能体有自动评测流水线;基于评测指标构建的护栏使幻觉与矛盾率降 20%;AI 解决率升 16%。
Cloudflare
自助配置智能体表层智能体让用户以对话方式配置自己的 Cloudflare 环境 —— Workers、DNS、网络设置 —— 就在一张纯『白页』上。用户是操作者,不是支持呼叫者。智能体把意图翻译成配置动作,并作用于用户自己的资源。
没有仪表盘;界面就是聊天。『白页』是刻意为之:智能体本身就是配置界面。结构化动作标签直接适用 —— 智能体返回的是它所做的配置变更,而不只是一段文本。
智能体追踪:智能体级 span(模型调用、工具执行、子智能体交接、token 用量)嵌套在 Workers 基础设施 span 内。兼容 OpenTelemetry,可导出到任何 OTLP 目的地 —— 同一份数据既支持排障,也驱动评测、分析与成本报表。
『智能体可以返回 HTTP 200 却仍然失败。』智能体感知式追踪提供两种视图:回放会话(完整对话)与检查追踪(执行瀑布流)。与 Lyft 相同的 SLO 纪律 —— 但遥测是智能体级而非 HTTP 级。
『用户即操作者』原型(§4.6)。与 Lyft 可配置拆分相同的纪律,应用于面向用户的配置。智能体以用户自己的权限作用于用户自己的资源,因此安全门禁的作用域是用户的环境,而非企业的数据。
10. 设计原则:对构建者意味着什么
- 1
架构是活的东西。发布一个能交接、收回控制权、重新路由的 supervisor —— 专家集会随数据增长、收缩、合并。
- 2
评测是产品门禁。用二元通过/不通过判定、窄的行为级 rubric、对照人工标注校准的 judge、离线仿真作为上线门禁、在线标注作为持续循环。
- 3
用户的『超范围』就是你的覆盖缺口。超范围率是覆盖指标,不是用户行为指标。
- 4
可观测性是反馈通道 —— 接入告警:错误率阈值、p95 SLO、工具调用成功率,越线就呼叫 on-call。
- 5
对话是知识来源。智能体不只是回答者,也是传感器。本体是持久资产;模型是工具。
- 6
Prompt 是产品规格书,不是代码注释。构建结构化模板、构建校验流水线,让领域专家先过 CI 再进生产。
- 7
用户可以是操作者。当用户配置自己的环境(Cloudflare 白页智能体)时,纪律相同 —— 结构化 prompt、评测、智能体级追踪、SLO —— 但信任模型改变:智能体作用于用户自己的资源,因此超范围边界与安全门禁的作用域是用户的环境,而非企业的数据。架构相同;权限模型不同。
11. EYwALINK 如何弥补这些缺口
EYwALINK 的四大战略支柱,正是对本白皮书所述问题的问题优先分解。 每个支柱对应一个章节;产品组合逐一闭合论文点名的缺口。
| 支柱 | 白皮书锚点 | 它补充什么 |
|---|---|---|
| 支柱 1 · AI 战略与架构 | §5.4 『架构在发布时并未完成』 + §6 模式 | 可执行 EA 把 TOGAF 目标态映射到 supervisor/专家拓扑,并让它成为随生产数据演进的活资产 —— 而不是发布即过时的图。 |
| 支柱 2 · AI 安全与隐私 | §4.1 『无边界且对抗性』 + prompt 校验 | 安全门禁、超范围定义、校验流水线里的 prompt 注入检测,是受监管 CX(电信、航空、医疗)的合规要求。数据不离开客户基础设施:本体、评测 judge、知识图谱全部运行在客户侧。 |
| 支柱 3 · 快速 AI 驱动应用开发 | §9 Lyft 『6 个月 → 2 周』 + 可配置拆分 | 『快速』意味着带 CI 门禁的结构化 prompt 模板,而不是随手写的 prompt。领域专家写 prompt;平台负责图构建、工具绑定、checkpoint 与 trace。 |
| 支柱 4 · AI 可观测性与运维 | §8 评测与运维 | 模型健康监测、自动性能回归检测、智能体故障检测、SLA 支持的事故响应,以及一支常在线、常担责的分数化(fractional)AI 运维团队。 |
产品组合与缺口的映射
§8.4 每智能体仪表盘 + SLO 接 PagerDuty —— 自托管于客户基础设施;数据不出边界。
§8.2 仿真基础设施 + §7.4 三级评测流水线 —— 用 mock 工具响应跑合成对话测试,在真实客户看到输出之前完成。
§8.3 分诊智能体 + ADLC 迭代循环 —— 读失败 trace 并自动开单的正是 Loop Factory 实例。
§10.1 的落地 —— 目标态图是持续循环的起点,生产数据回流到架构。
§4.6 / §10.7 『用户即操作者』(Cloudflare 白页)—— 支柱 3(快速 AI 驱动开发)是构建机制;支柱 4(可观测性)让用户信任作用于自己资源的智能体;白页体验是配置智能体所需的最小界面。用户拥有资源,因此支柱 2 是更相关的约束。
参考栈(LangGraph + LangSmith + PagerDuty)是客户不拥有的专有平台。运维纪律两边相同 —— 当你自己拥有基础设施时,不同的是:超范围边界、本体、trace 数据 与评测 judge 全部成为客户资产,而不是平台依赖。零锁定、私有 AI 不是妥协,而是受监管 CX 环境中 AI 安全与隐私的前提。
12. 参考资料
- · How Lyft Built a Self-Serve AI Agent Platform for Customer Support with LangGraph and LangSmith — Akshay Sharma,Lyft SCX 数据科学与 MLE 团队,2026 年 5 月 27 日
- · The Agent Development Lifecycle — LangChain,2026 年 5 月 9 日
- · Customer Experience Agents in Production: Lessons from Lyft, Vodafone, and LATAM Airlines — LangChain 现场笔记
- · Introducing: Cloudflare Agents — Nevi Shah、Matt Simpson、Fred Schott,Cloudflare,2026 年 8 月
- · What is an AI agent? — Cloudflare Learning
- · Agent setup — Cloudflare Developer Docs — Cloudflare
所有数字与引用均可追溯至上列来源。
四重视角把 CX 智能体变成一个运营系统
参考栈是你在租的平台。而纪律 —— 结构化 prompt、校准的二元评测、每日评测节奏、SLO 支撑的告警、分诊智能体 —— 两边都一样。
开始
本文的主要来源:来自 Lyft、沃达丰、LATAM 航空的经验。
看目标态图如何在生产数据回流中保持为活资产。
我们把四重视角接到你的 CX 智能体系统 —— 前几周交付仪表盘、SLO 与分诊智能体。
想在你的 CX 智能体系统上用四重视角?联系我们 —— 我们会在你的栈上规划 2 周评测流水线 + SLO 接线。